离线打开
完整解压 Windows x64 ZIP,运行 Liss.TextLab.exe,无需安装 .NET,文本和模型均在本机处理。
分词、词频、校对与文件检索,在本机探索文字结构和语义线索。
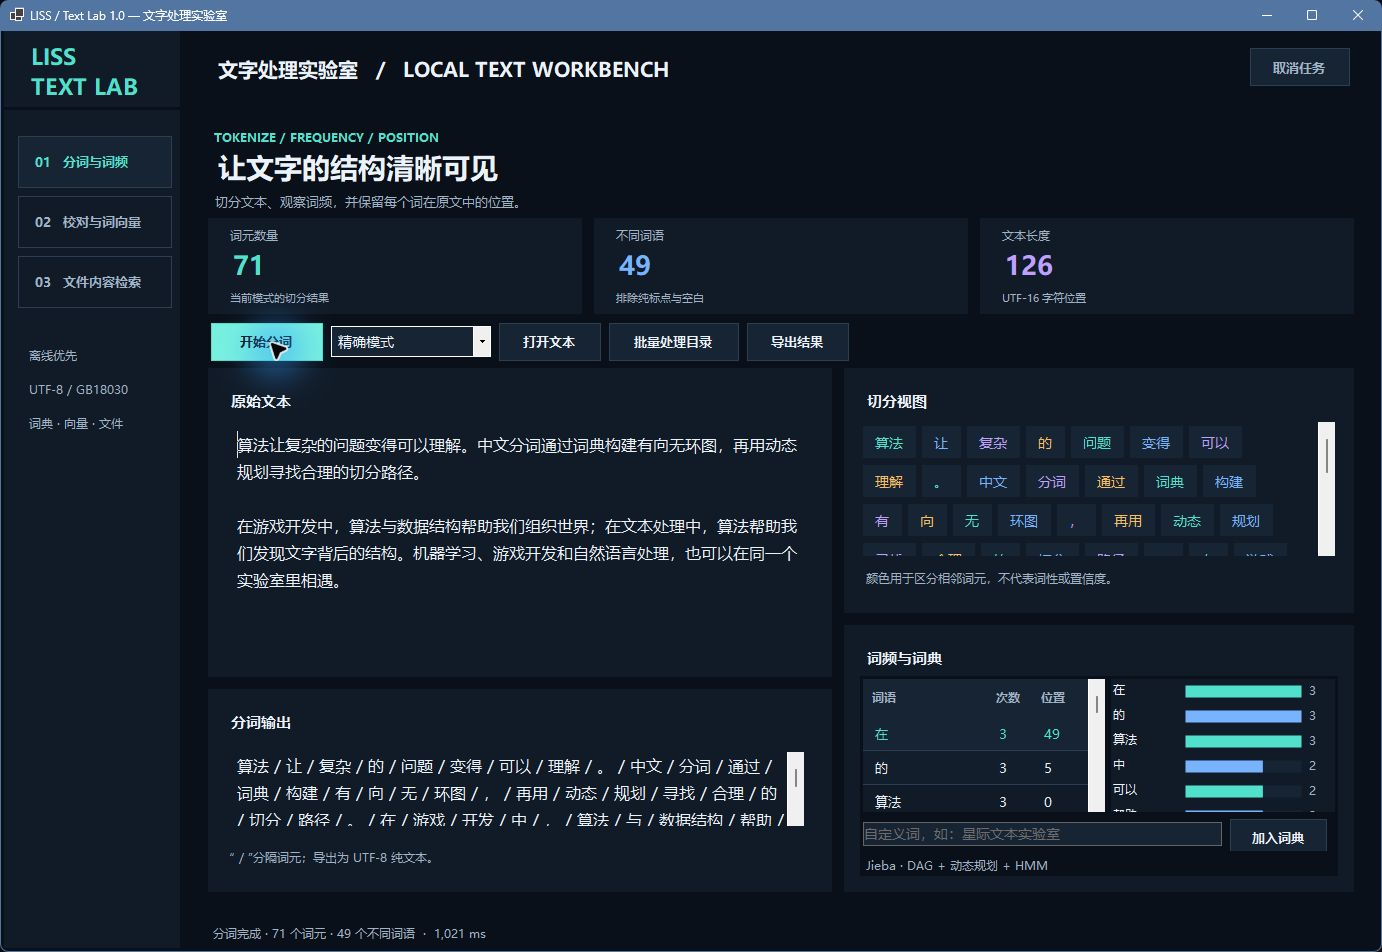
原文、切分视图、词频表与分布条形图组成分词工作区。
从自写的改错字、分词工具与 FindText 延伸出的本地文字实验室。分词观察结构,校对给出可确认的建议,文件检索把线索定位到具体路径和行号。
精确、搜索、全模式配合原文位置、词频表与条形图;自定义词可在当前会话生效。
文本在本机处理,批量输出保留相对目录;原文与结果分开,支持取消并保留已完成文件。
 放大查看
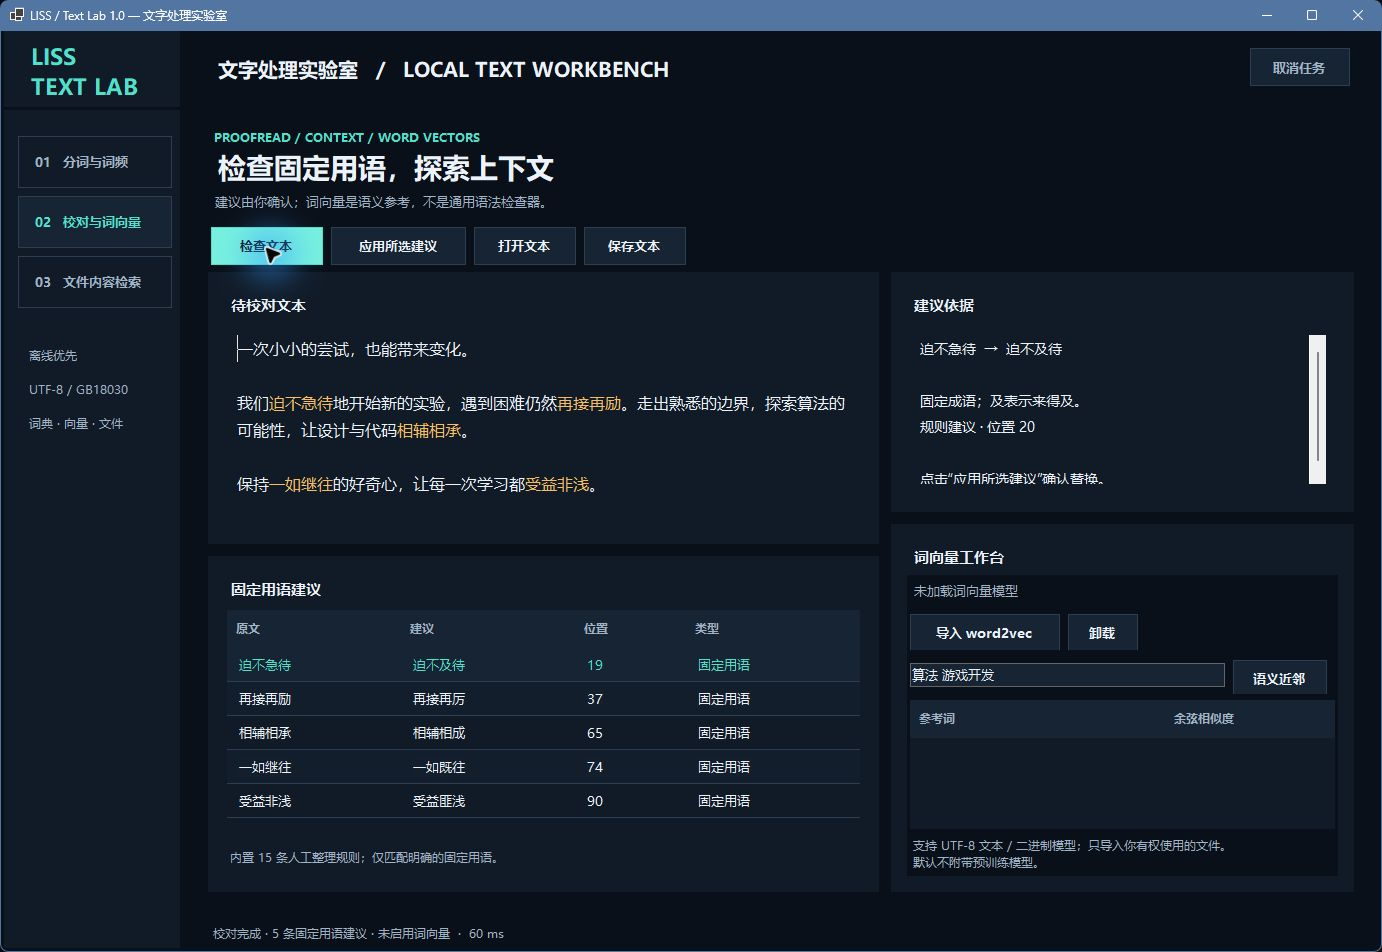
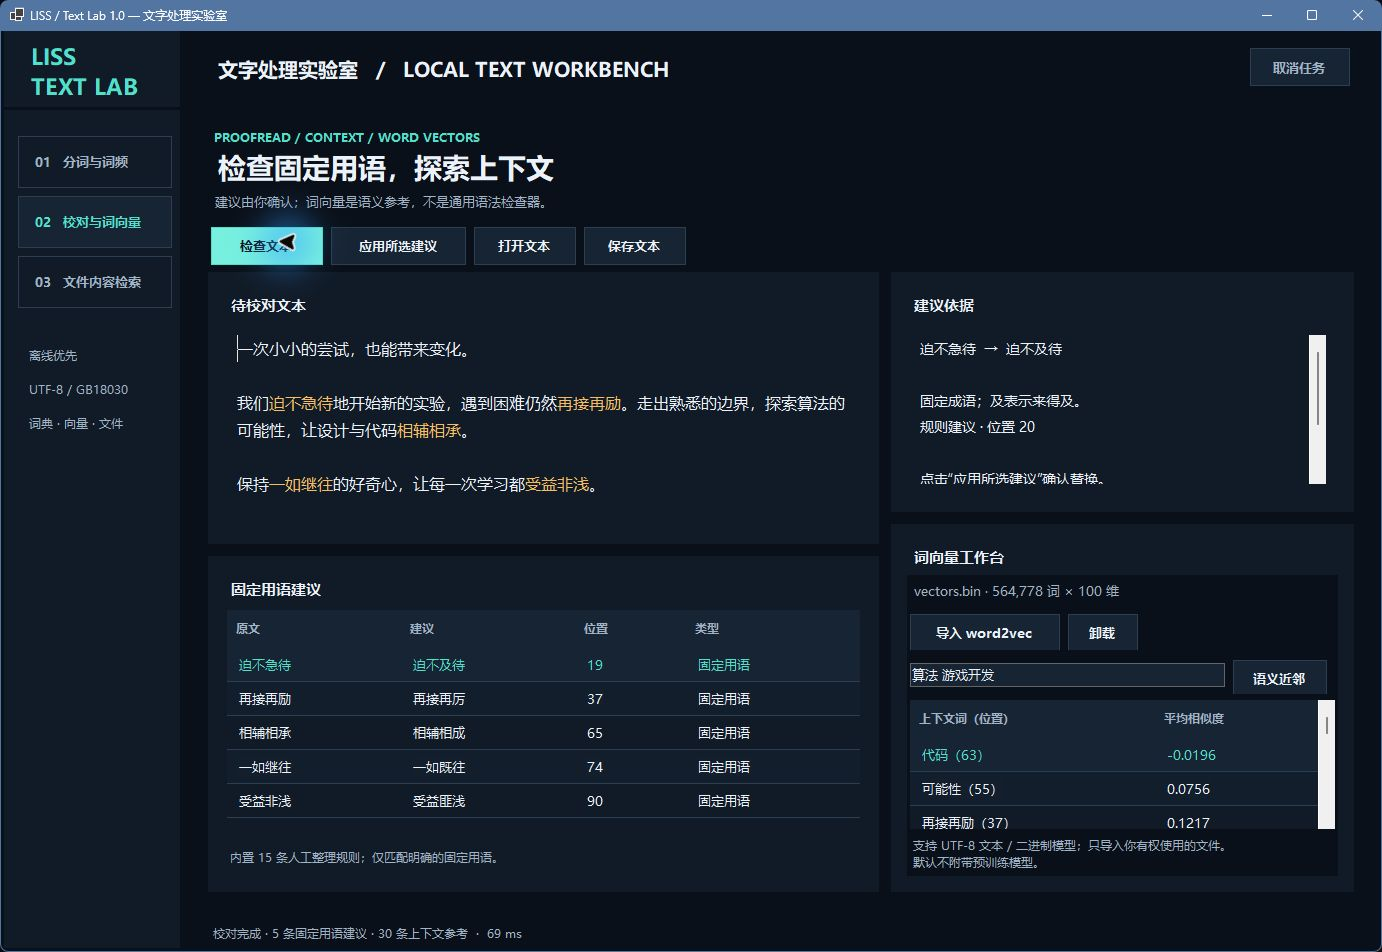
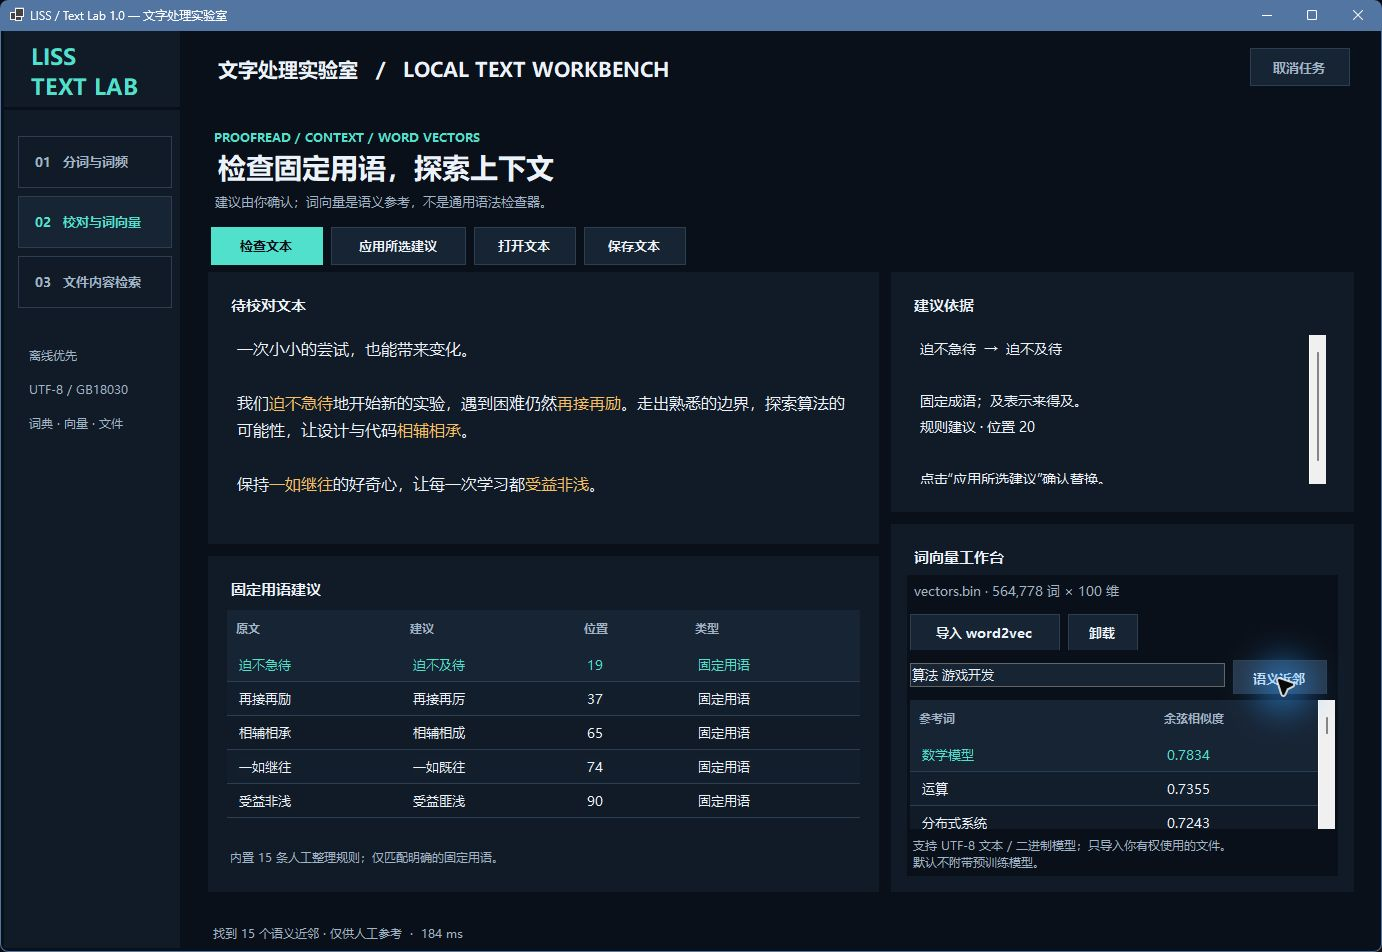
固定用语规则说明修改理由;词向量提供相似度参考,语义差异不会直接被当成错字。
读取文本或二进制 word2vec;归一化、逐词扫描与固定大小优先队列控制近邻检索的空间开销。
 放大查看
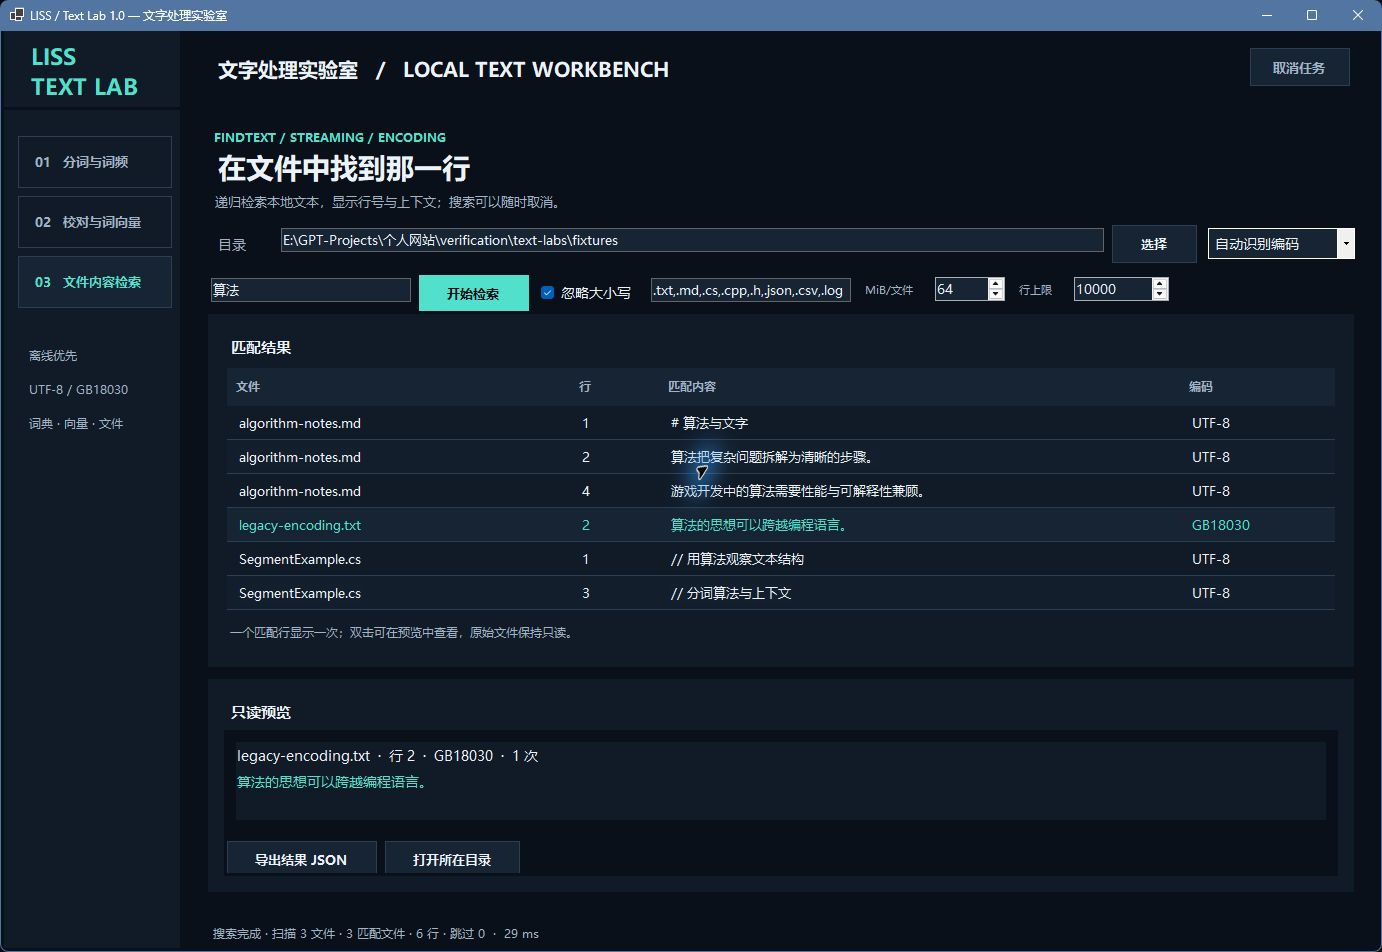
按 BOM 与严格 UTF-8 校验选择编码,无 BOM 文本也可手动指定;每个文件只按一种编码搜索,保留路径、行号和出现次数。
流式匹配、有限长行预览与协作取消保持工作台响应;跳过原因和已找到的部分结果都可以查看。
点击图片,放大查看。
中文分词由第三方 Jieba 实现提供。规则校对与词向量参考分开呈现,语义相似度不等于纠错准确率;无 BOM 文本可手动指定编码。
校对默认是 15 条固定用语规则,不是通用纠错模型。预训练词向量不随程序提供;语义功能需导入自己有权使用的模型。
完整解压 Windows x64 ZIP,运行 Liss.TextLab.exe,无需安装 .NET,文本和模型均在本机处理。
粘贴或打开文本查看分词与词频;在校对页逐项确认建议,在检索页选择目录和关键词。批量输出与原文目录分开。
导入自己有权使用的 word2vec .bin 或文本 .vec / .txt,查看语义近邻和双侧上下文;默认不附带 word2vec 词向量模型。